Projeto
Minerar moedas DETI em CPUs e GPUs
Um projeto de desempenho em C e CUDA que explora SIMD, OpenMP, pesquisa na GPU e um servidor TCP, com medições das experiências originais.
Uma moeda DETI é uma mensagem de 52 bytes cujo hash MD5 termina em pelo menos oito zeros hexadecimais. Encontrar uma exige, em média, cerca de 4,3 mil milhões de tentativas. O enunciado deu-nos um ciclo pequeno com muito trabalho pela frente: gerar uma candidata, calcular o hash, verificar o resultado e repetir.
Fiz a maior parte da implementação deste projeto de Arquiteturas de Alto Desempenho, realizado em 2024 na Universidade de Aveiro e entregue com a Matilde Teixeira. Partimos do código de referência fornecido pelo Tomás Oliveira e Silva e acrescentámos outras implementações da pesquisa, vetores mais largos, execução em vários núcleos, um minerador CUDA e um servidor TCP para recolher as moedas. Nas experiências originais, os resultados foram de cerca de 9,76 milhões de tentativas por segundo numa única thread do CPU até 4,54 mil milhões numa GTX 1050 Mobile.
Oito mensagens num vetor
Cada candidata é independente, o que torna a pesquisa adequada à execução em paralelo. Com SIMD, uma thread pode avançar vários cálculos MD5 ao mesmo tempo: quatro candidatas na versão AVX, oito com AVX2 e dezasseis com AVX-512F.
O que faz a diferença é a disposição dos dados. Um vetor AVX2 contém a primeira palavra de 32 bits de oito mensagens diferentes. O vetor seguinte contém a segunda palavra de cada uma, e assim sucessivamente. Uma adição ou operação bit a bit executa então o mesmo passo nos oito hashes.
O núcleo MD5 fornecido está especializado para mensagens de 52 bytes, pelo que uma candidata e o respetivo preenchimento cabem num único bloco MD5. As macros definem operações como a rotação e o acesso aos dados, permitindo que as implementações escalar, vetorial e CUDA partilhem as rondas do hash.
O OpenMP acrescenta outra camada: cada thread do CPU tem os seus próprios buffers de candidatas e processa o seu lote de posições dos vetores. O cálculo dos hashes fica fora das secções críticas; a inicialização e a gravação das moedas encontradas precisam de coordenação. No fim, as reduções juntam as contagens de tentativas e de moedas.
Deixar as candidatas sem sucesso na GPU
A maioria dos hashes não dá em nada. Copiar cada candidata para a GPU e trazer cada resultado de volta transferiria muitos dados só para concluir que quase tudo pode ser descartado.
O kernel CUDA gera as candidatas no dispositivo, combinando bytes aleatórios, valores derivados da thread e um contador fornecido pelo CPU. Cada thread da GPU verifica 95 candidatas por lançamento. Quando uma passa a verificação, um atomicAdd reserva espaço para a mensagem num buffer de saída partilhado.
O CPU lê esse buffer de 4 KiB, guarda ou encaminha as moedas encontradas e lança outro lote. A geração de candidatas e os hashes sem sucesso ficam na GPU. A transferência pode ser pequena porque o resultado que interessa é raro.
O que mostram as medições
Estas taxas vêm das contagens de tentativas das execuções originais de 120 segundos. São resultados históricos do relatório do projeto, não novas medições.
| Pesquisa | Hardware | Tentativas por segundo, aproximadamente |
|---|---|---|
| Escalar, uma thread | Intel Core i7-7700HQ | 9,76 milhões |
| AVX, uma thread | Intel Core i7-7700HQ | 28,06 milhões |
| AVX2, uma thread | Intel Core i7-7700HQ | 50,94 milhões |
| AVX-512F, uma thread | AMD Ryzen 7 7745HX | 134,98 milhões |
| CUDA | NVIDIA GTX 1050 Mobile | 4,54 mil milhões |
A comparação mais direta é no mesmo CPU: o AVX2 testou cerca de 5,2 vezes o número de candidatas da versão escalar de referência. O resultado AVX-512 inclui também uma mudança de máquina. As contagens de tentativas medem o trabalho realizado, pelo que candidatas repetidas também contam.
Uma comparação separada no relatório, com AVX2/OpenMP, chegou a 79,936 mil milhões de tentativas em 120 segundos com a depuração desativada. A versão de depuração chegou a 13,559 mil milhões. Essa diferença inclui tanto a escrita de informação de diagnóstico como uma mudança de compilação de -O0 para -O2; não pode ser atribuída apenas à remoção de mensagens no terminal.
Uma frase pode mudar o custo da pesquisa
Uma das variantes encontra moedas que contêm texto fornecido pelo utilizador. Preserva a frase, acrescenta quatro bytes aleatórios e incrementa os restantes caracteres imprimíveis. Quando esse contador se esgota, gera novos bytes aleatórios e recomeça.
Em 120 segundos, a frase AAD! permitiu cerca de 75,38 mil milhões de tentativas. A frase mais longa, Arquiteturas Alto Desempenho 24/25!!, permitiu cerca de 713 milhões. Ocupa os 36 bytes de texto disponíveis, deixando um byte para o contador depois do prefixo aleatório. Cada posição do vetor precisa de ser reinicializada ao fim de apenas 95 candidatas.
O cálculo do hash não mudou. Mudou a quantidade de trabalho à volta dele. Foi um bom exemplo de como otimizar apenas as rondas MD5 não explica o desempenho de toda a pesquisa.
Várias máquinas, um cofre
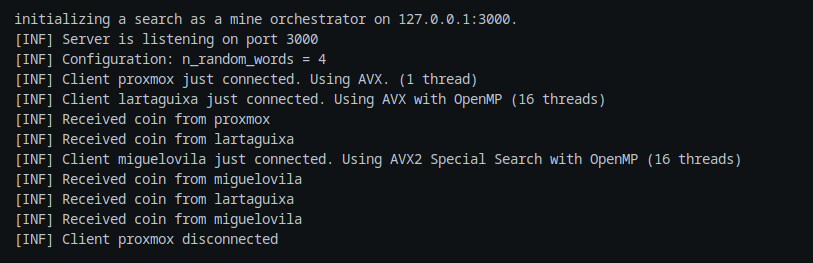
O servidor TCP permite que diferentes implementações de pesquisa enviem resultados para o mesmo servidor. Um cliente envia HELLO com o nome da máquina, a implementação e o número de threads; o servidor devolve CONFIG; as moedas encontradas chegam em mensagens COIN_FOUND. A captura acima vem do relatório original e mostra clientes a usar diferentes modos de pesquisa em conjunto.
O servidor volta a calcular o hash antes de guardar uma moeda recebida. Não atribui intervalos de pesquisa distintos, pelo que os vários clientes podem repetir trabalho. Essa seria uma melhoria clara para execuções distribuídas mais longas, a par da sincronização do acesso ao cofre partilhado.
Há também uma compilação separada da pesquisa escalar com Emscripten. Corre no navegador, de forma independente dos clientes nativos. O relatório regista mil milhões de tentativas tanto num portátil como num Pixel 8; a versão guardada no repositório usa um número fixo mais pequeno.
O repositório inclui instruções de compilação e verificações de correção por comparação com md5sum. O relatório original contém as medições, e o enunciado documenta o código de referência de que partimos.